Les LLM atteignent un plateau
(publié initialement le 27 août 2025)*
Pas une révolution, mais une amélioration incrémentale
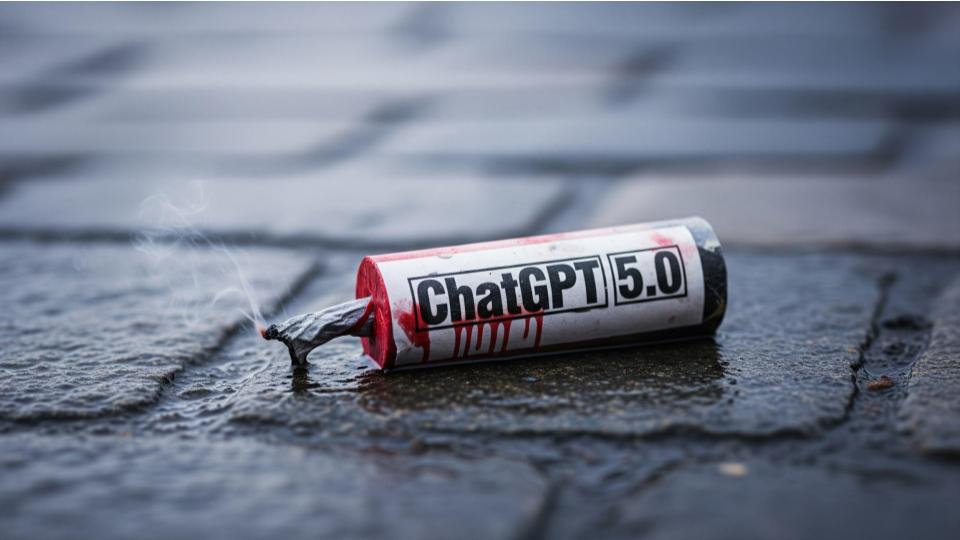
Après plus de deux ans d'anticipation, de battage médiatique, de promesses d'IA générale (AGI) et même de "superintelligence", le récent GPT-5 s'avère être un pétard mouillé. Ce qui explique probablement sa sortie en plein milieu de l'été, le 7 août 2025.
Pourtant, les attentes étaient élevées et pleinement soutenues par des promesses extravagantes. Rappelons que le 21 mai 2024, lors du Microsoft Build 2024, Kevin Scott, CTO de Microsoft, et Sam Altman d'OpenAI, avaient déclaré : "Nous sommes loin du point de rendements décroissants marginaux dans la puissance que nous pouvons donner aux modèles d'IA en augmentant l'échelle de calcul." Sam Altman avait également affirmé que le bond de GPT-4 à GPT-5 serait aussi significatif que celui de GPT-3 à GPT-4.
La courbe exponentielle est en réalité une sigmoïde
L'hypothèse quasi-religieuse d'une intelligence artificielle croissante par mise à l'échelle (plus de données, plus de calcul) s'est heurtée à un mur. Pour les grands modèles de langage (LLM), plus grand et plus haut ne signifie pas plus intelligent.
La courbe d'évolution des LLM n'est pas l'exponentielle rêvée — c'est plutôt une sigmoïde, bien connue des praticiens des réseaux de neurones. Ce que nous savons, c'est que la courbe a commencé comme une exponentielle et montre des signes clairs de ralentissement, s'aplatissant sur un plateau.
"La chose la plus importante à retenir sur GPT-5, c'est que les LLM atteignent un plafond." — Claude Coulombe
Les progrès de GPT-5 par rapport à GPT-4 ne sont tout simplement pas comparables aux gains de performance des générations précédentes. Ces conclusions sont cohérentes avec celles de Gary Marcus, expert en IA et sceptique notoire de l'approche LLM pour atteindre l'AGI.
"Personne doté d'intégrité intellectuelle ne devrait encore croire que la mise à l'échelle pure nous mènera à l'AGI." — Gary Marcus
Les LLM ne raisonnent pas — ils font semblant
Une étude du groupe de recherche en IA d'Apple, "The Illusion of Thinking", a remis en question l'idée que les LLM peuvent raisonner en généralisant à n'importe quelle profondeur. Ils ont montré que les LLM échouent sur des versions modérément complexes d'algorithmes de base comme la Tour de Hanoï.
Une autre étude, "Is Chain-of-Thought Reasoning of LLMs a Mirage?" de chercheurs de l'Arizona State University, montre que la chaîne de pensée — la trace supposée de raisonnement dans les chatbots basés sur les LLM — est "en grande partie un mirage fragile." Dès qu'un problème s'écarte légèrement des données d'entraînement, le pseudo-raisonnement s'effondre complètement.
Des chercheurs d'Anthropic ont découvert que les étapes de la chaîne de pensée ne correspondent pas réellement au résultat : un modèle peut avoir des étapes correctes mais produire un résultat incorrect. Les LLM sont des simulateurs sophistiqués de texte de raisonnement, pas de véritables moteurs de raisonnement.
Les confabulations restent non résolues
Le problème des confabulations (mal nommées hallucinations) persiste et n'a pas été résolu après près de trois ans et de nombreuses promesses. En quelques jours après le lancement de GPT-5, le web était inondé d'erreurs identiques à celles commises par ses prédécesseurs.
Ce modèle, supposément au niveau "expert avec un doctorat" selon Sam Altman, n'est toujours pas capable de compter de manière fiable les lettres dans un mot ou d'effectuer des opérations arithmétiques de base. Le comportement erratique du module de sélection de modèle de GPT-5 au lancement en dit long sur le contrôle qualité.
Ce que cela signifie pour les organisations
Ce plateau ne rend pas l'IA inutile — les LLM restent précieux pour :
- L'assistance à la rédaction et à la création de contenu
- La complétion et la révision de code
- La synthèse et la recherche d'informations
- Les tâches où les humains assurent le contrôle qualité
Mais pour les applications critiques, l'humain doit rester dans la boucle. Par la nature même des systèmes basés sur les LLM, nous ne pouvons pas garantir leur fiabilité. Les confabulations peuvent être réduites avec des techniques comme le RAG, mais jamais complètement éliminées.
La voie à suivre
L'hypothèse que la mise à l'échelle seule mènerait à l'AGI a été infirmée. Nous devons maintenant revenir à la méthode scientifique : évaluation rigoureuse, benchmarking honnête, et cadres de gouvernance qui correspondent aux capacités réelles plutôt qu'aux promesses des fournisseurs.
L'avenir d'une adoption productive de l'IA ne réside pas dans la poursuite de la prochaine version de GPT, mais dans le déploiement responsable des capacités actuelles — avec un périmètre clair, une gouvernance robuste et des attentes réalistes.